V Keboole testujeme. Opravdu hodně testujeme. A když jedno kolečko v CI trvá přes dvě hodiny, člověk začne přemýšlet, kam ten čas mizí.
Máme celkem 2 589 E2E testů a 5 127 unit testů. Unit testy nás moc netíží, v CI jejich běh trvá řádově minuty. Pouštíme je všude. V PR při každém commitu i nad master. Ale ty E2E testy. Je jich sice méně, ale opravdu provolávají celý systém. Od API přes fronty až po backendové databáze jako Snowflake a BigQuery.
K celkovému počtu E2E testů se přidají ještě data providery a skončíme na čísle 3 626 jednotlivých spuštění testů v CI. A tohle TRVALO dlouho. Celé kolečko trvalo přes dvě hodiny, z toho minimálně hodinu a půl jen E2E testy. Zbytek byl setup a další kontroly. Občas se běh ještě protáhl, protože některé operace, zvlášť kolem BigQuery, potřebovaly retry kvůli eventual consistency.
BTW, z unit testů máme asi 40 % mock-heavy a stále víc si v týmu myslíme, že takové unit testy jsou v agentic engineeringu zbytečné. AI je vždy napíše „zelené“. Nějak se k tomu řešení dostane a vás to stojí tokeny na generování, další tokeny na úpravy testů, když se něco změní, a většinou to nikdo detailně číst nebude. Jen budou brát drahocenný čas na jeden turn. Ale o tom jindy.
Cesta k testům kolem hodiny
Nejprve jsme zkusili klasické: přidáme nějaké resources, přidáme další stroj na E2E testy jen pro PR, ať je průchod pro master rychlejší. Nic z toho zásadně nepomohlo.
I když musím uznat, že podpora v GitHub Actions, kterou jsem připravil, pro spuštění jen jedné suity, jejího výseku nebo dokonce jediného testu velmi zrychlila možnost otestovat PR ještě předtím, než půjde do master. A hodně pomohla celému týmu.
Kam čas mizí?
Na začátku jsme byli slepí. V CI jsme neměli podrobné časy, ze kterých by bylo vidět, co přesně je žere. Prvním mým krokem bylo tedy přidání několika metrik, které následně rozhodovaly o celé další optimalizaci.
Doplnil jsem měření API volání v jednotlivých fázích testu. Kolik zabere příprava prostředí, kolik vlastní test, kolik čekání na asynchronní joby a kolik následný úklid.
A tady začaly vylézat zajímavé věci. Pomocné metody se znovu a znovu ptaly přes API na stejné informace. Někde dokonce první API call vracel všechno potřebné pro setup testu a vzápětí se suita zeptala na detail resource se stejnými informacemi. Jednotlivě to byly malé, krátké a nenápadné operace, které ale dohromady ukrajovaly pořádný kus běhu.
Třeba jedna taková kontrola udělala za běh suity přes pět tisíc requestů a zabrala přes dvanáct minut. Přitom potřebné informace šly získat z jediného listingu. Jiná pomocná metoda přidávala ke každému testu asi čtyři sekundy. To samo o sobě nezní strašně. Jenže v jedné suitě to dohromady dělalo skoro 27 minut.
Uklízej si po sobě!
Další pohled na měření setUp, samotného testu a tearDown mě překvapil. Naše testy trávily obrovský kus času v setUp. Kontrolovaly, jestli objekty, které potřebují, existují, jestli v nich nejsou zbytky z minula — neposlušný test, co si neuklízí, nebo spadlý test, co uklidit nestihl — a znovu zakládaly potřebné resources.
Hodně testů bylo taky napsaných s neunikátními názvy resources a jejich běh a úklid mívaly daleko větší dosah, než je zdrávo. Při souběhu mohl jeden test smazat něco, co jiný ještě potřeboval.
A to se velmi hezky hledá a ladí. Test jednou projde, podruhé spadne a při samostatném spuštění se zase tváří, že je všechno v pořádku, protože mu nikdo nesahá na práci :-)
V dalším kroku jsem opravil názvy resources, aby si každý test vytvářel vlastní unikátní objekty a staral se jen o ty své. Opravil jsem i úklid, aby nezasahoval do jiných sad, a celé to zjednodušil.
Pořádně to šlo testovat jen v CI, kde může běžet vedle sebe opravdu hodně testů. Tady velmi pomohl CI server, o kterém jsem se zmiňoval na začátku a který umožňuje spouštět jednotlivé suity. Celé testovací kolečko se mi zkrátilo z několika hodin na pár desítek minut.
Izolace testů mi zároveň připravila půdu pro další krok. Pro zvýšení paralelismu a přidávání procesů, které testy spouštějí.
Všichni už jsou v cíli, jeden ještě závodí
Pak přišlo dělení práce. Náš runner na začátku dělil testy do paralelních chunků podle jejich počtu a prostého seřazení. Jenže dvě stejně velké hromady testů můžou zabrat úplně jinou dobu.
V jednom chunku skončila pomalá třída a proces ji zpracovával skoro hodinu, zatímco ostatní už měly hotovo. Paralelně to tedy běželo, ale konec celé sady pořád zdržoval jeden opozdilec.
Přidal jsem tedy ukládání délek jednotlivých testů do artefaktu v GitHub Actions. Časy jsem vzal z JUnit reportu. Každý další běh si runner nejdřív načetl uložené časy a rozdělil testy do chunků tak, aby všechny trvaly přibližně stejně.
Pokud chyběla data pro celou suitu, zachoval předchozí rozdělení. Pokud chyběl čas jednoho testu, přiřadil mu medián délky testů v dané suitě. Další běh už měl vlastní naměřenou hodnotu.
Jen tu byl jeden háček: běh nad master potřeboval vlastní historii časů. Artefakt z PR ji sám nenahradil. Takže nad PR jsem to vyzkoušené měl, ale první běh nad master ještě běžel pomalu. Teprve uložil časy pro další běhy. Pak přišel očekávaný skok o desítky minut.
Musí stíhat i druhá strana
Testy při běhu tolik nezatěžují samotný GitHub Actions runner. Volají skutečná API, zakládají prostory a čekají na data z Kebooly. Ale servery, které to všechno zpracovávají, se při tolika paralelních testech docela zapotí.
Dalším kouskem skládačky tedy bylo měřit, jak dlouho testy čekají na asynchronní zpracování na pozadí, a sledovat v Datadogu vytížení našich workerů.
Zjistil jsem, že máme workery poddimenzované. Nestačilo navýšit jen zdroje hlavní aplikace, jak jsem psal na začátku. Úzkým hrdlem byla i další komponenta systému. Víc paralelních testů by před ní jen vytvořilo delší frontu.
Po těchto změnách se samotné E2E testy dostaly přibližně na hodinu. Medián úspěšných běhů od 14. října večer vychází na 66 minut. Celé kolečko včetně přípravy a dalších kontrol má asi hodinu a půl.
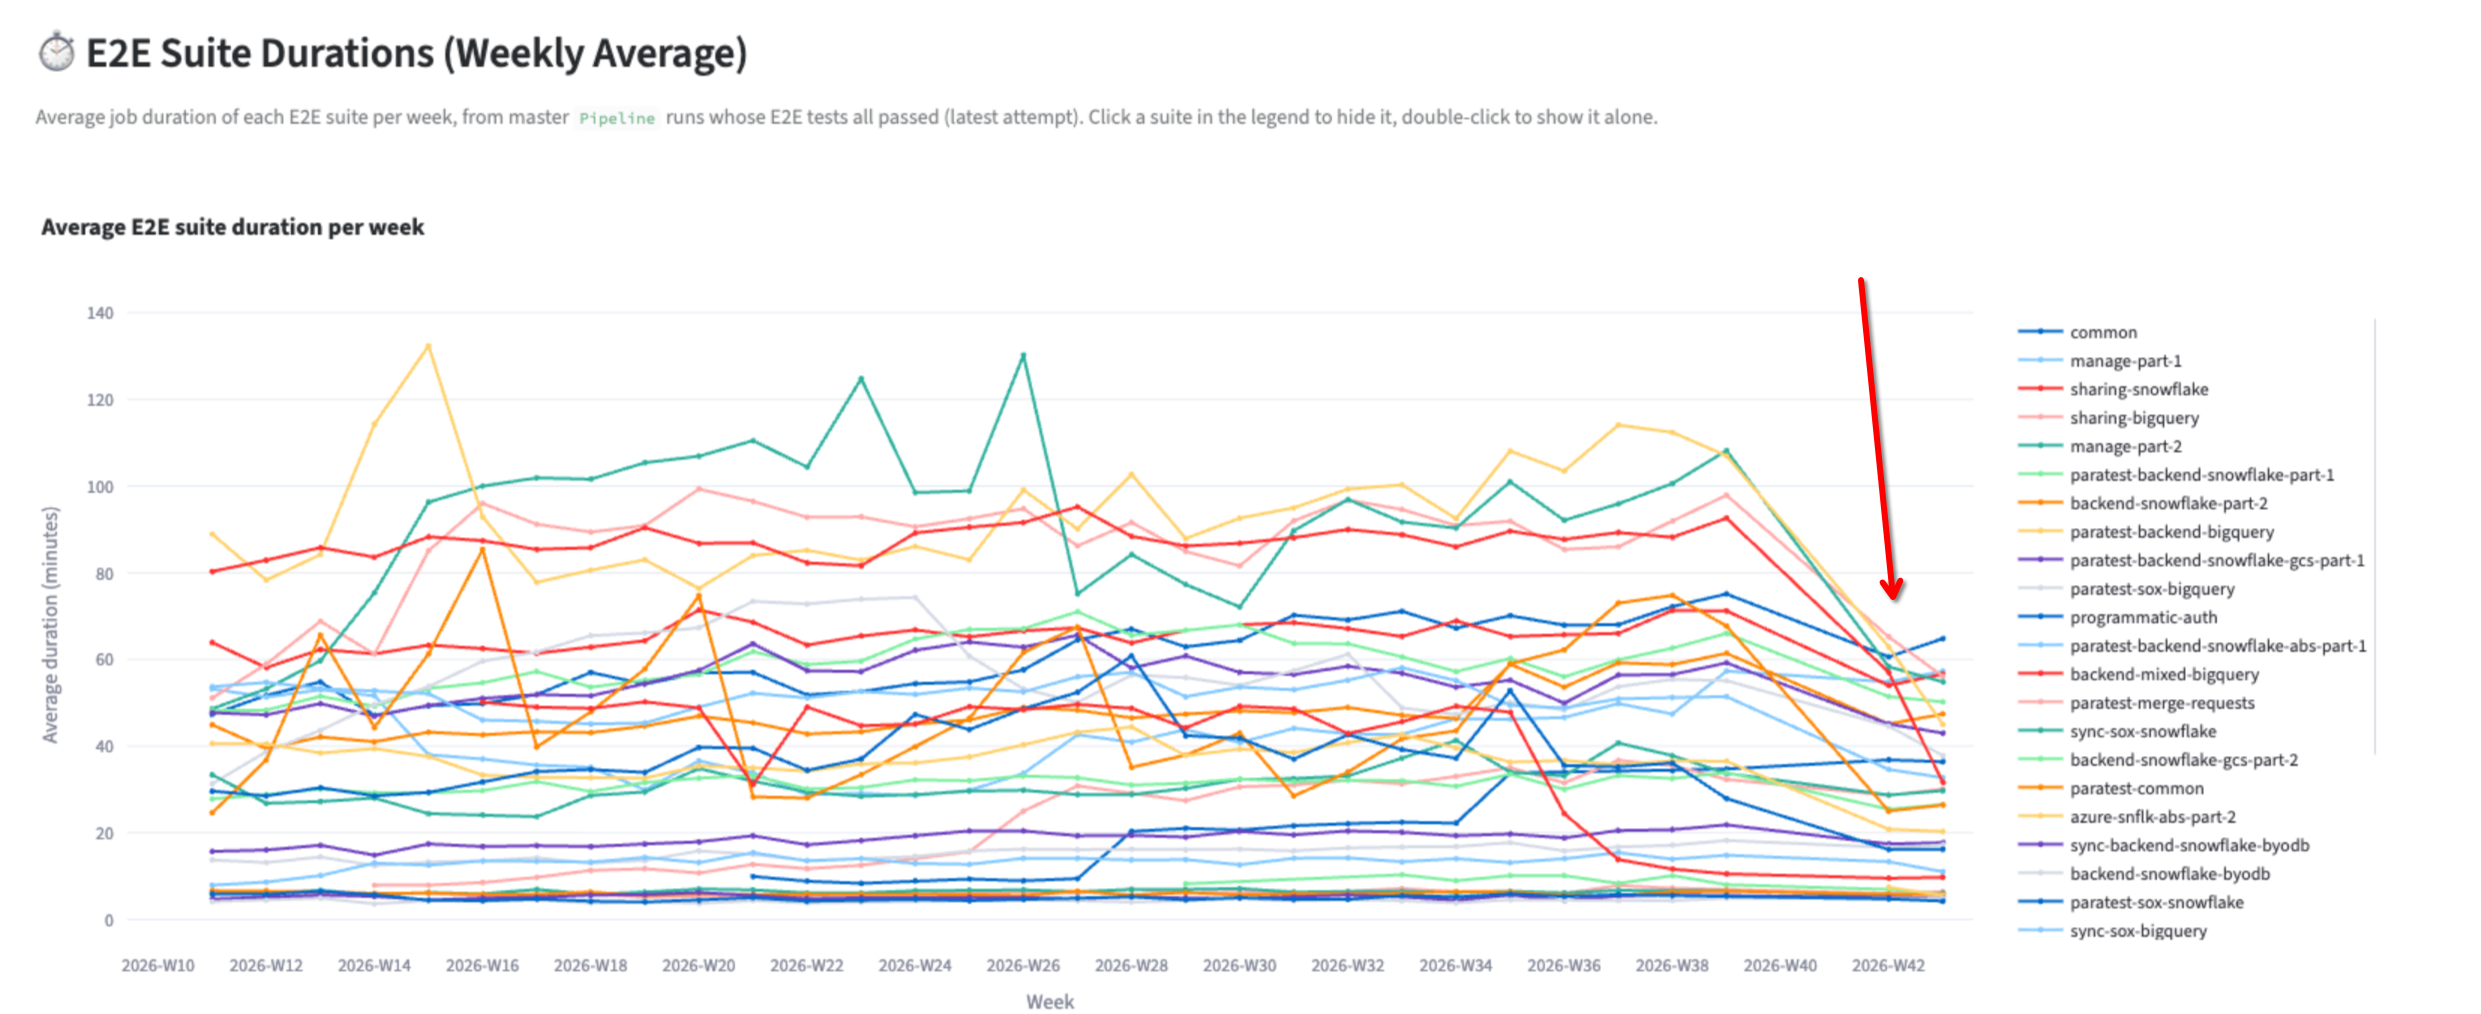
Když vezmu delší období, vychází srovnání takhle:
| Úspěšné E2E běhy | 14. dubna – 12. května | 30. září – 28. října |
|---|---|---|
| Počet běhů | 22 | 90 |
| Průměrná délka | 102 min | 69 min |
| Medián délky | 101 min | 67 min |
| Medián runner-minut | 1 075 | 901 |
To je o 32 % kratší průměrné čekání na úspěšný E2E běh. Přitom se počet suit zvýšil z 28 na 31. Runner-minuty, tedy součet času jednotlivých jobů, klesly v mediánu o 16 %. Nejde tedy jen o to spálit víc strojového času najednou.
Měřím tu čas od startu první E2E suity do konce poslední. Čekání ve frontě a nasazení prostředí v těchto číslech nejsou. A pořád porovnávám úspěšné běhy: padající běhy s retry umějí být dlouhé dál. U všech běhů zůstalo p90 na 152 minutách. Starší vzorek úspěšných běhů je navíc menší, takže bych z jednotlivých minut nedělal vědu.
V týmu zároveň pozorujeme, že před zrychlením jsme dokázali dostat do produkce dva až tři balíky PR denně. Teď jich je šest až osm a občas i deset. Samotné měření CI samozřejmě nedokazuje, že za celý rozdíl může zrychlení testů. Ale kratší čekání nám dává víc prostoru dodávat další změny.
Třešničky z reportů
Při celé práci na zrychlení se mi několikrát stalo, že jeden test běžel opakovaně. Třeba dvakrát spadl a napotřetí prošel. V testech totiž máme množství retry, hlavně kvůli BigQuery, ale i dalším operacím.
Zaznamenal jsem i případ, kdy test padal konzistentně, ale retry protáhly celou suitu na dvě a půl hodiny. Pak ji zařízl náš GitHub Actions runner.
A nešlo jen o opakování testů. Testovací klienti měli vlastní retry s exponenciálním backoffem. Jediná deterministická chyba tak mohla test zdržet asi o 34 minut, než vůbec dostal šanci selhat. Když se pak opakovala ještě suita, čekali jsme znovu. U těchto klientů jsme proto počet pokusů omezili na jeden.
Do artefaktů jsem doplnil i zprávu o tom, které testy potřebovaly retry a kolik času tím strávily.
Nově také náš workflow píše ke každému PR zprávy, jestli byly testy spuštěné, jestli čekají, běží a jak skončily.
Protože #context matters!
Tyhle detaily pomáhají nejen nám vývojářům, ale i našim agentům. Nemusejí informace dohledávat dalšími dotazy na GitHub API.
Hackathon
Většina práce se udála na třídenním týmovém hackathonu. Zavřeme se, kodíme od rána do večera u jednoho stolu, pijeme pivko a baštíme krávy a bejčky na grilu. Dodělávky pak přišly během týdne po hackathonu.
Takovou aktivitu můžu všem vřele doporučit. Vždycky mám pocit, že za ty tři dny absolutního focusu dodáme tolik práce jako za celý měsíc.
